|
Weihan Xu I am a first-year PhD student at the University of Washington, Seattle, and a member of the NeuroAI Lab advised by Prof. Eli Shlizerman. My research focuses on multimodal sensing and perception, generative models, and embodied intelligence: building object-centric, physics-informed multimodal systems that integrate sight, sound, and touch for entertainment and embodied applications. If you are interested in collaborating, please feel free to reach out via email. I have collaborated closely with researchers at Sony Research, MIT CSAIL, and Berkeley AI Research on multimodal learning, specializing in audio-visual and visual-tactile learning. I obtained my MSCS from Duke University, and I completed my undergraduate studies at the University of Michigan, double majoring in Computer Science (Honors) and Data Science. I began studying music at age six and have formal training in piano, violin, and French horn. |
|
Selected Publications |
* denotes equal contribution.
|
ACTS: Learning Visuo-Tactile World Models from Human Physical Interaction
Yuxiang Ma*, Weihan Xu*, Pengfei Ye, Anna Mei, Ray Yuxin Song, Tingle Li, Haonan Chen, Yilun Du, Edward H. Adelson CoRL 2026 Workshops: Do Robots Need World Models? & PhysWM |
|
|
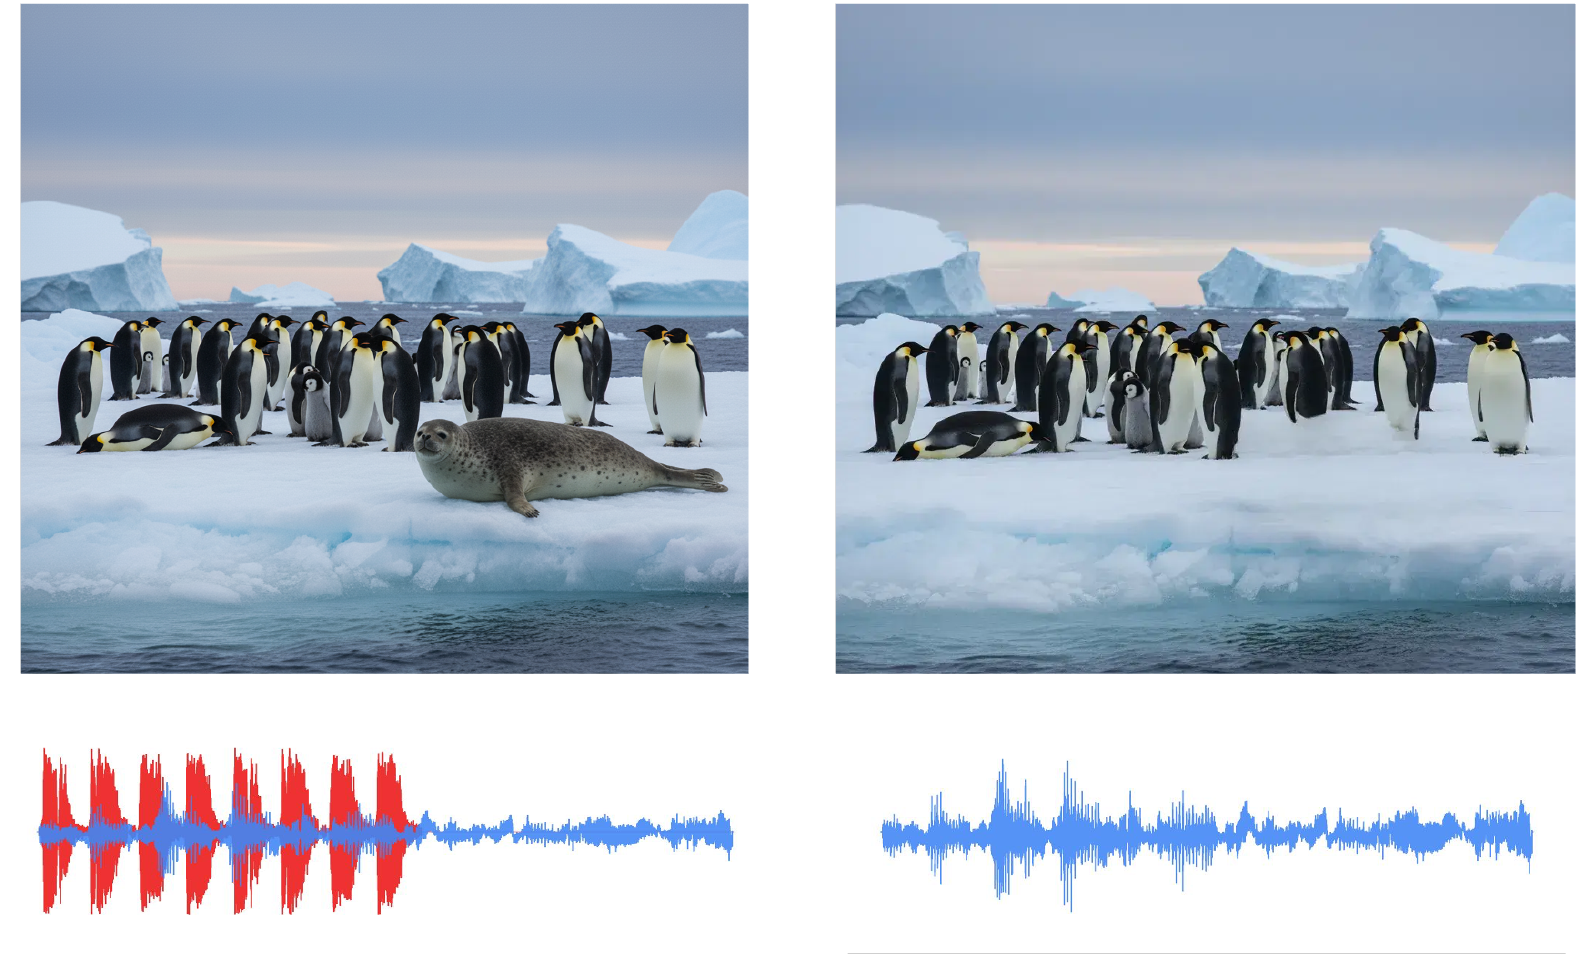
AVIO: Learning to Add and Remove Sounding Objects in Audiovisual Scenes
Weihan Xu, Kan Jen Cheng, Koichi Saito, Jingyu Shi, Tingle Li, Yisi Liu, Liming Wang, Masato Ishii, Takashi Shibuya, Gopala Anumanchipalli, Paul Pu Liang Preprint, 2026 |
|
|
Schrödinger Audio-Visual Editor: Object-Level Audiovisual Removal
Weihan Xu*, Kan Jen Cheng*, Koichi Saito, Jehanzeb Mirza, Tingle Li, Yisi Liu, Alexander Liu, Liming Wang, Masato Ishii, Takashi Shibuya, Yuki Mitsufuji, Gopala Anumanchipalli, Paul Pu Liang Preprint, 2026 arXiv / demo |
|
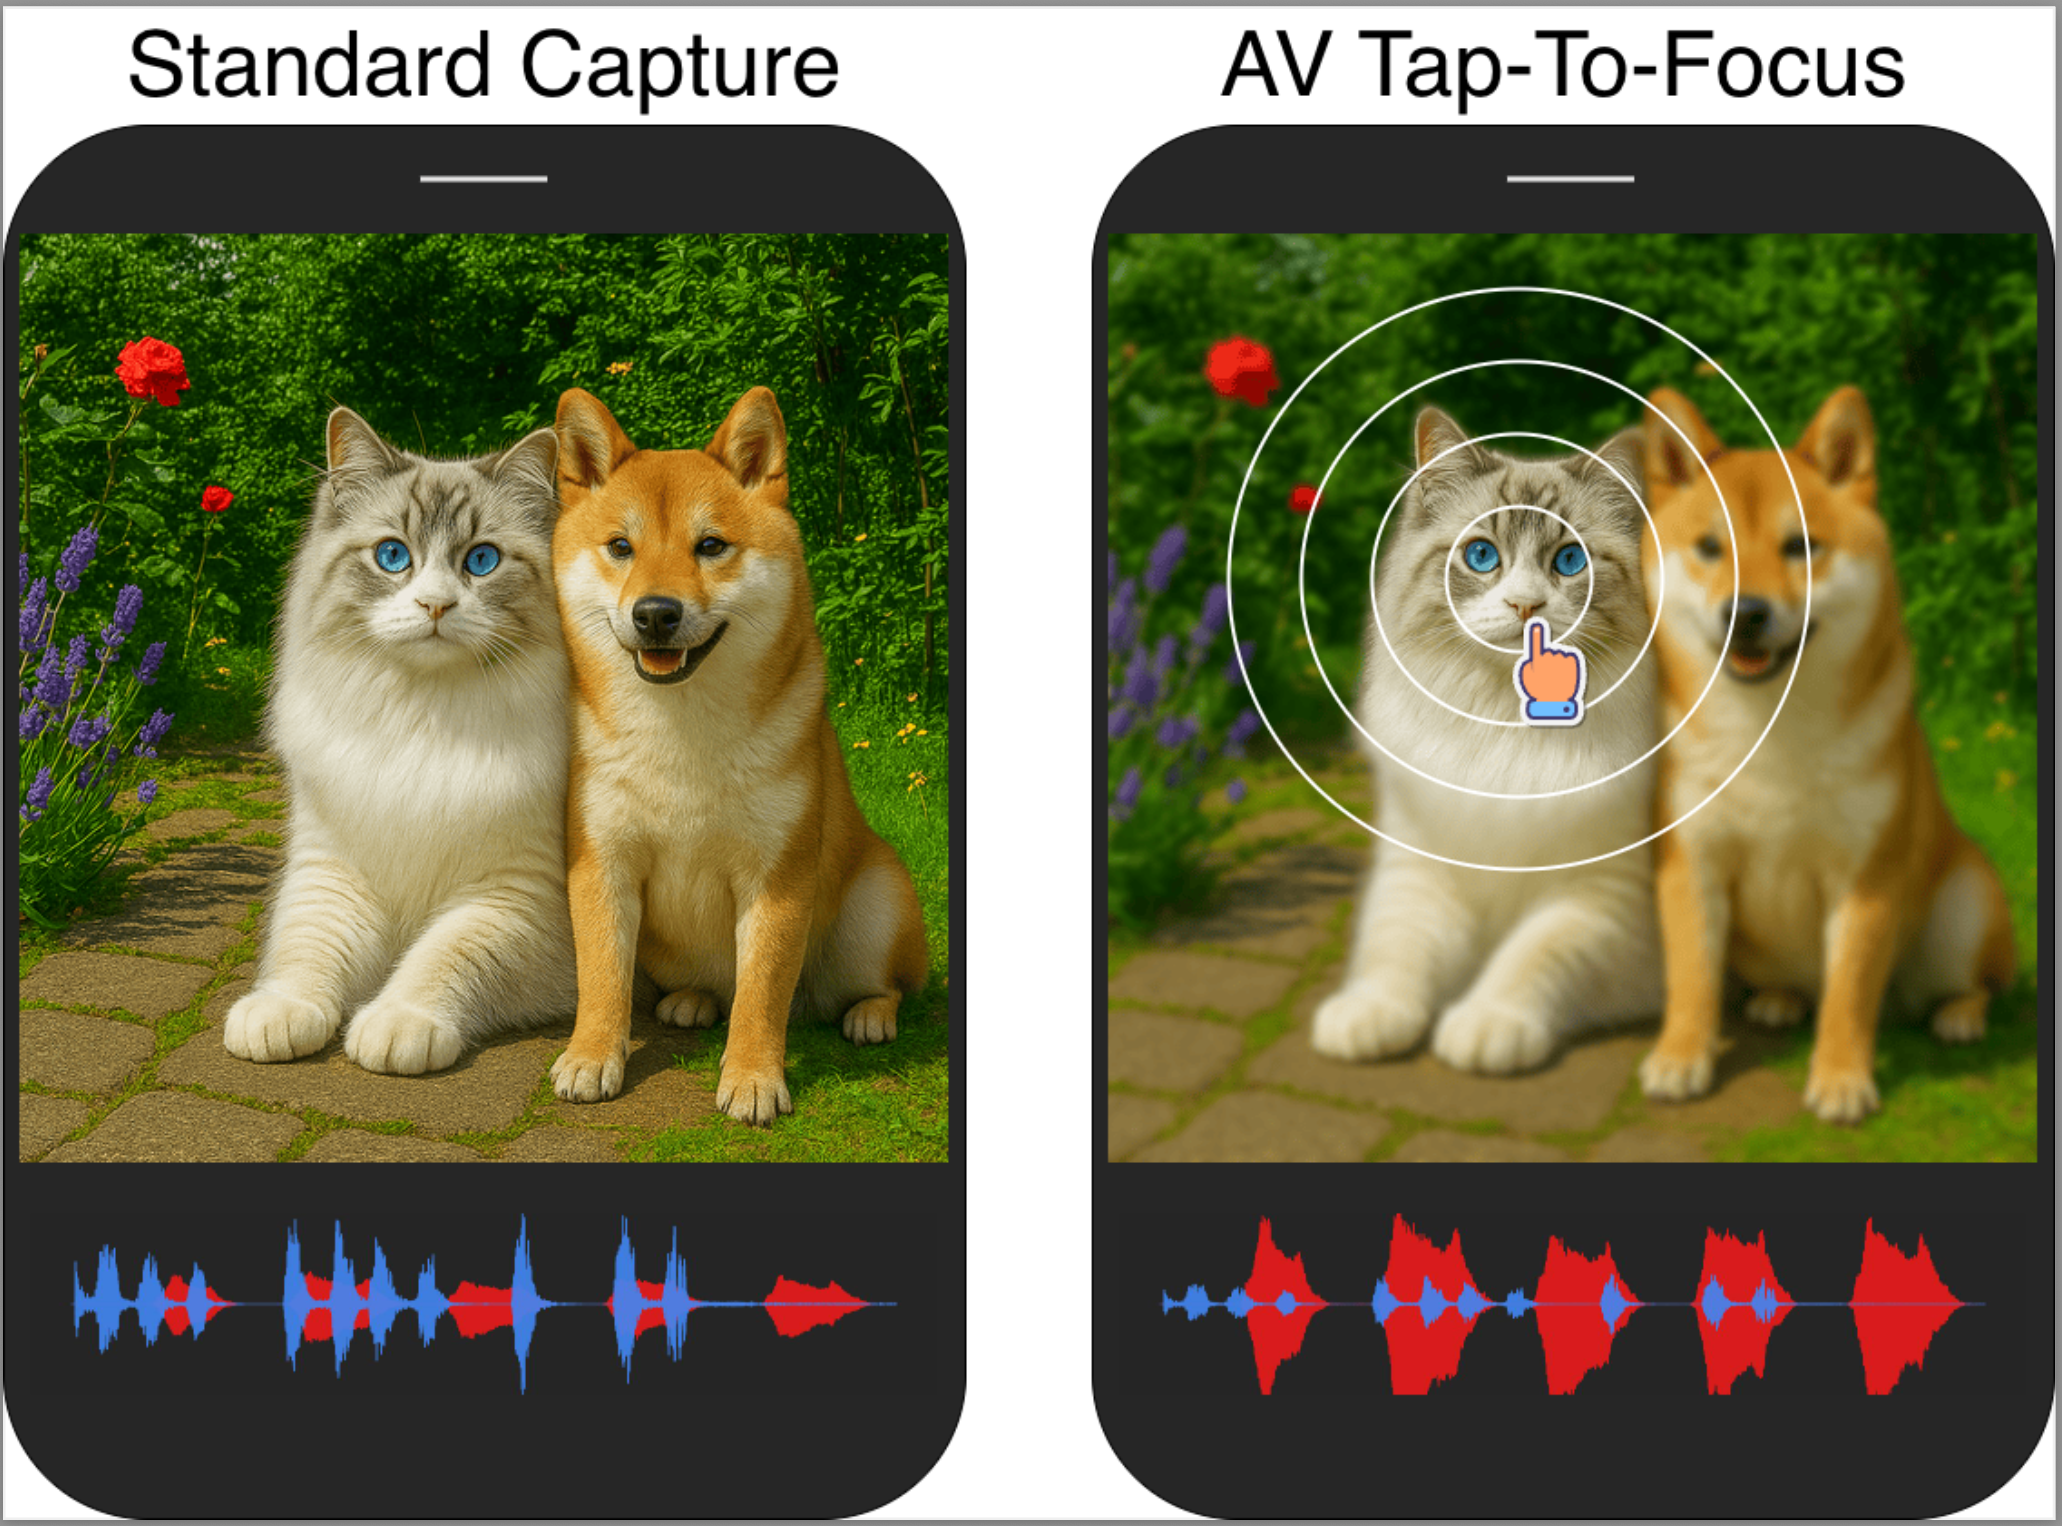
CAVE: Coherent Audio-Visual Emphasis via Schrödinger Bridge
Kan Jen Cheng*, Weihan Xu*, Koichi Saito, Nicholas Lee, Yisi Liu, Jiachen Lian, Tingle Li, Alexander Liu, Fangneng Zhan, Masato Ishii, Takashi Shibuya, Paul Pu Liang, Gopala Anumanchipalli Preprint, 2026 |
|
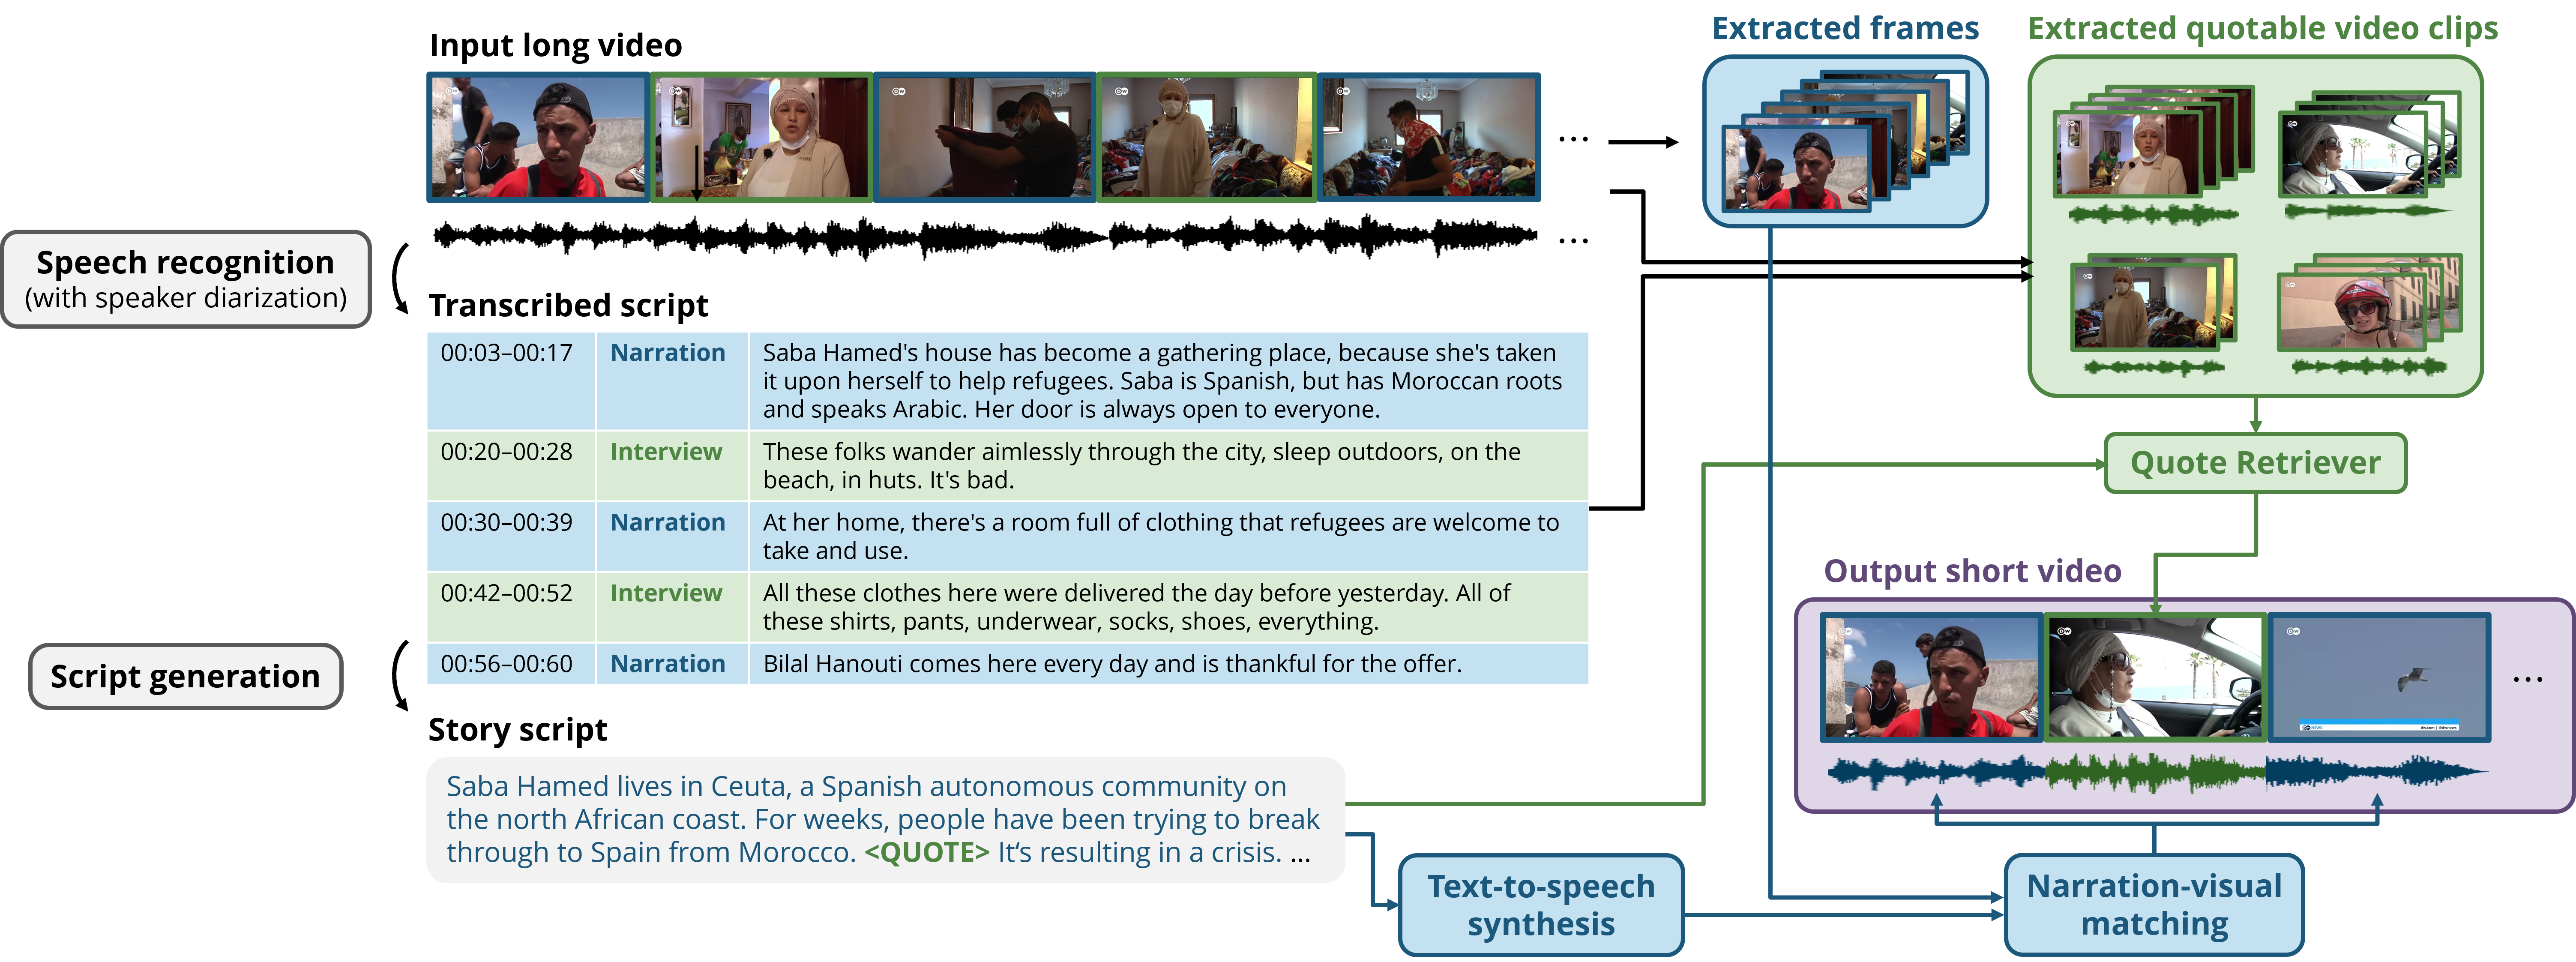
REGen: Multimodal Retrieval-Embedded Generation for Long-to-Short Video Editing
Weihan Xu, Yimeng Ma, Jingyue Huang, Yang Li, Wenye Ma, Taylor Berg-Kirkpatrick, Julian McAuley, Paul Pu Liang, Hao-Wen Dong NeurIPS, 2025 arXiv / demo / code |
|
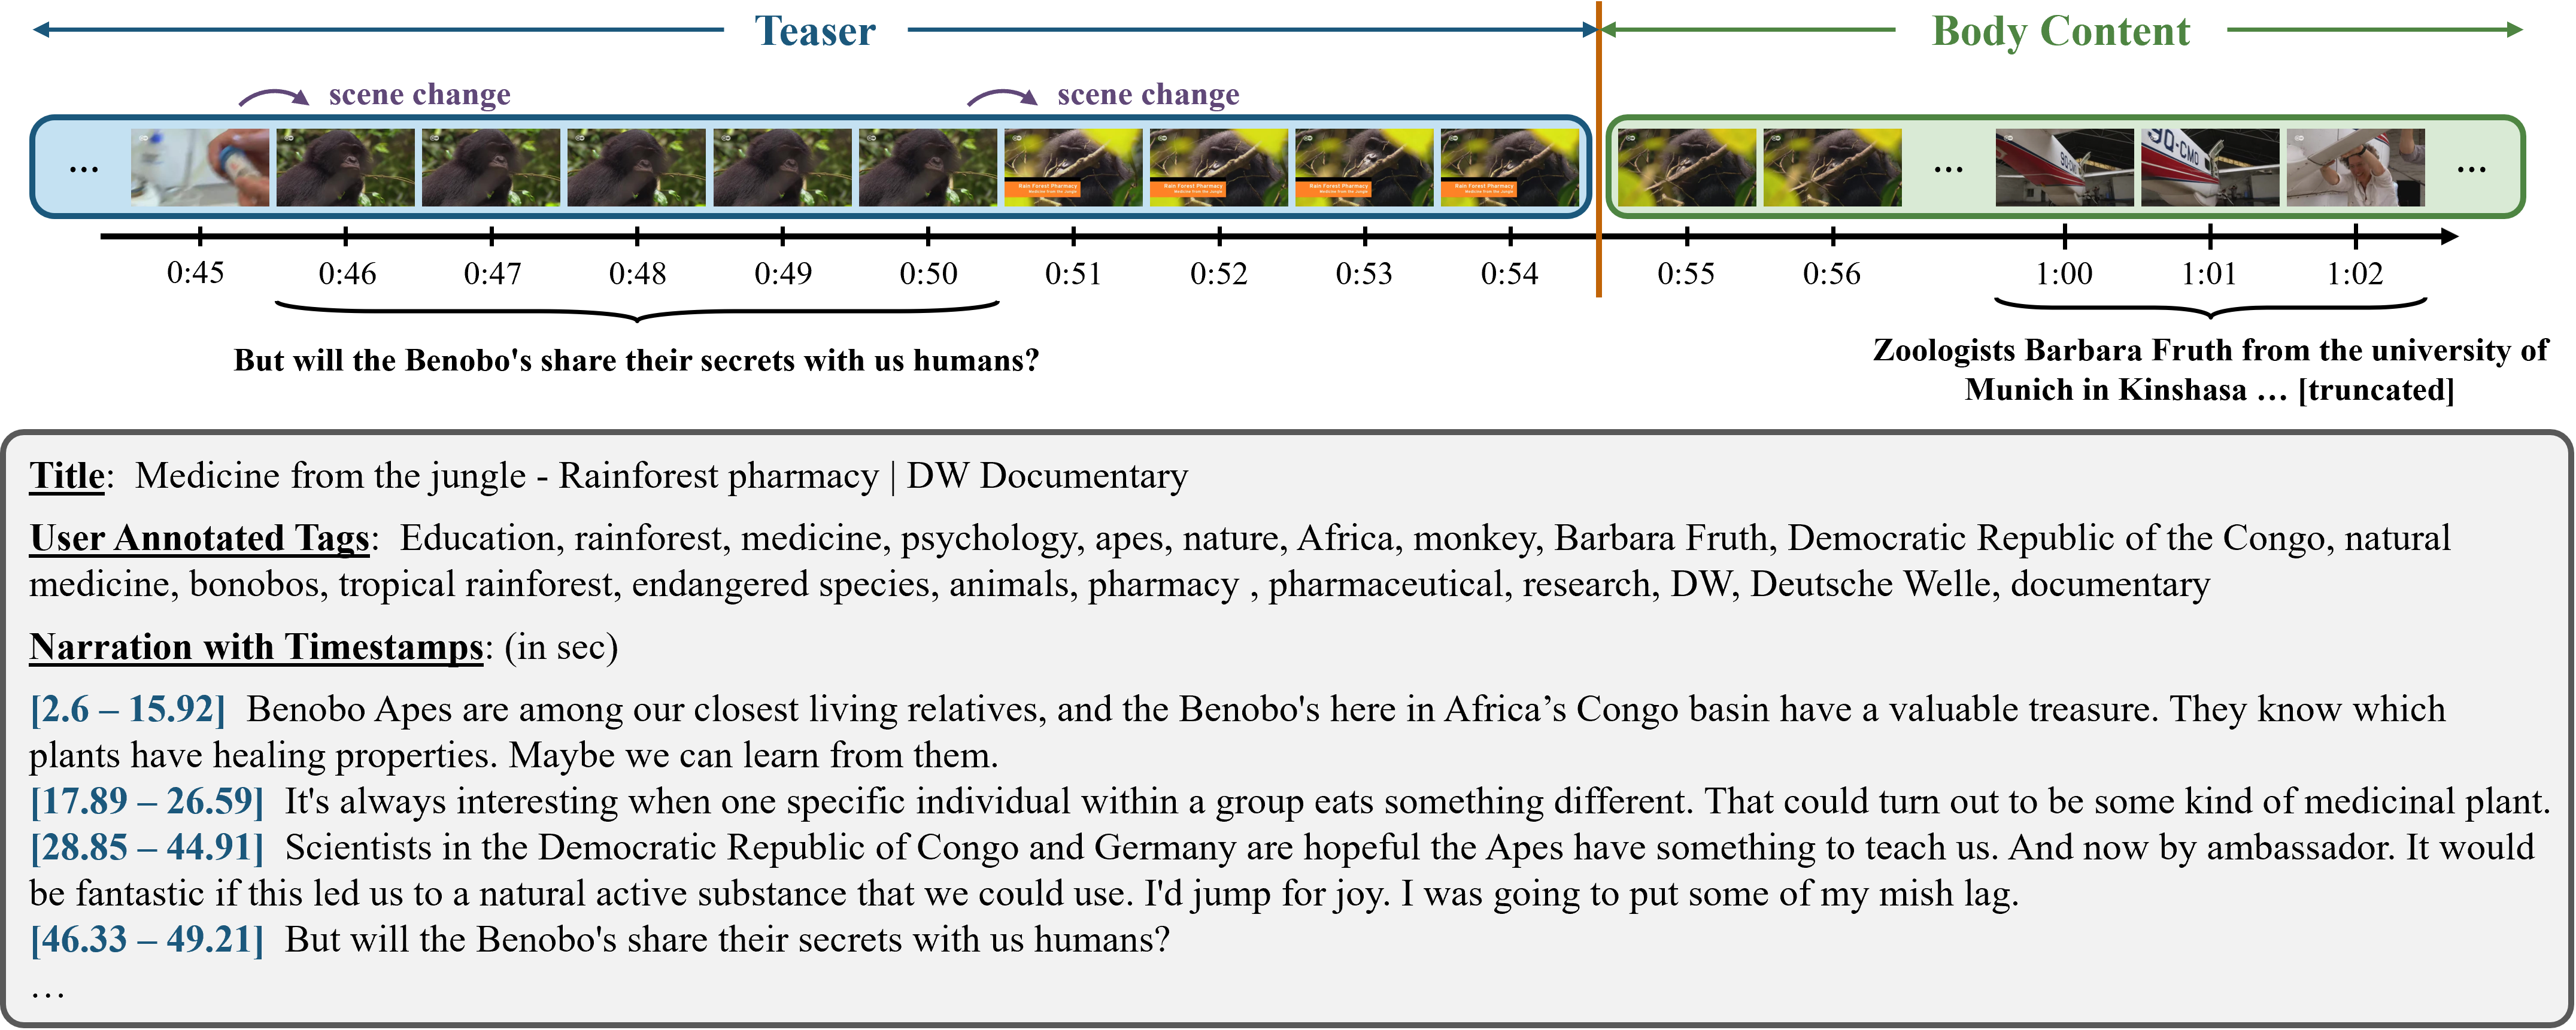
TeaserGen: Generating Teasers for Long Documentaries
Weihan Xu, Paul Pu Liang, Haven Kim, Julian McAuley, Taylor Berg-Kirkpatrick, Hao-Wen Dong The International Conference on Learning Representations (ICLR), 2025 arXiv / demo / code We introduce DocumentaryNet and propose two models TeaserGen-PT and TeaserGen-LR |
|
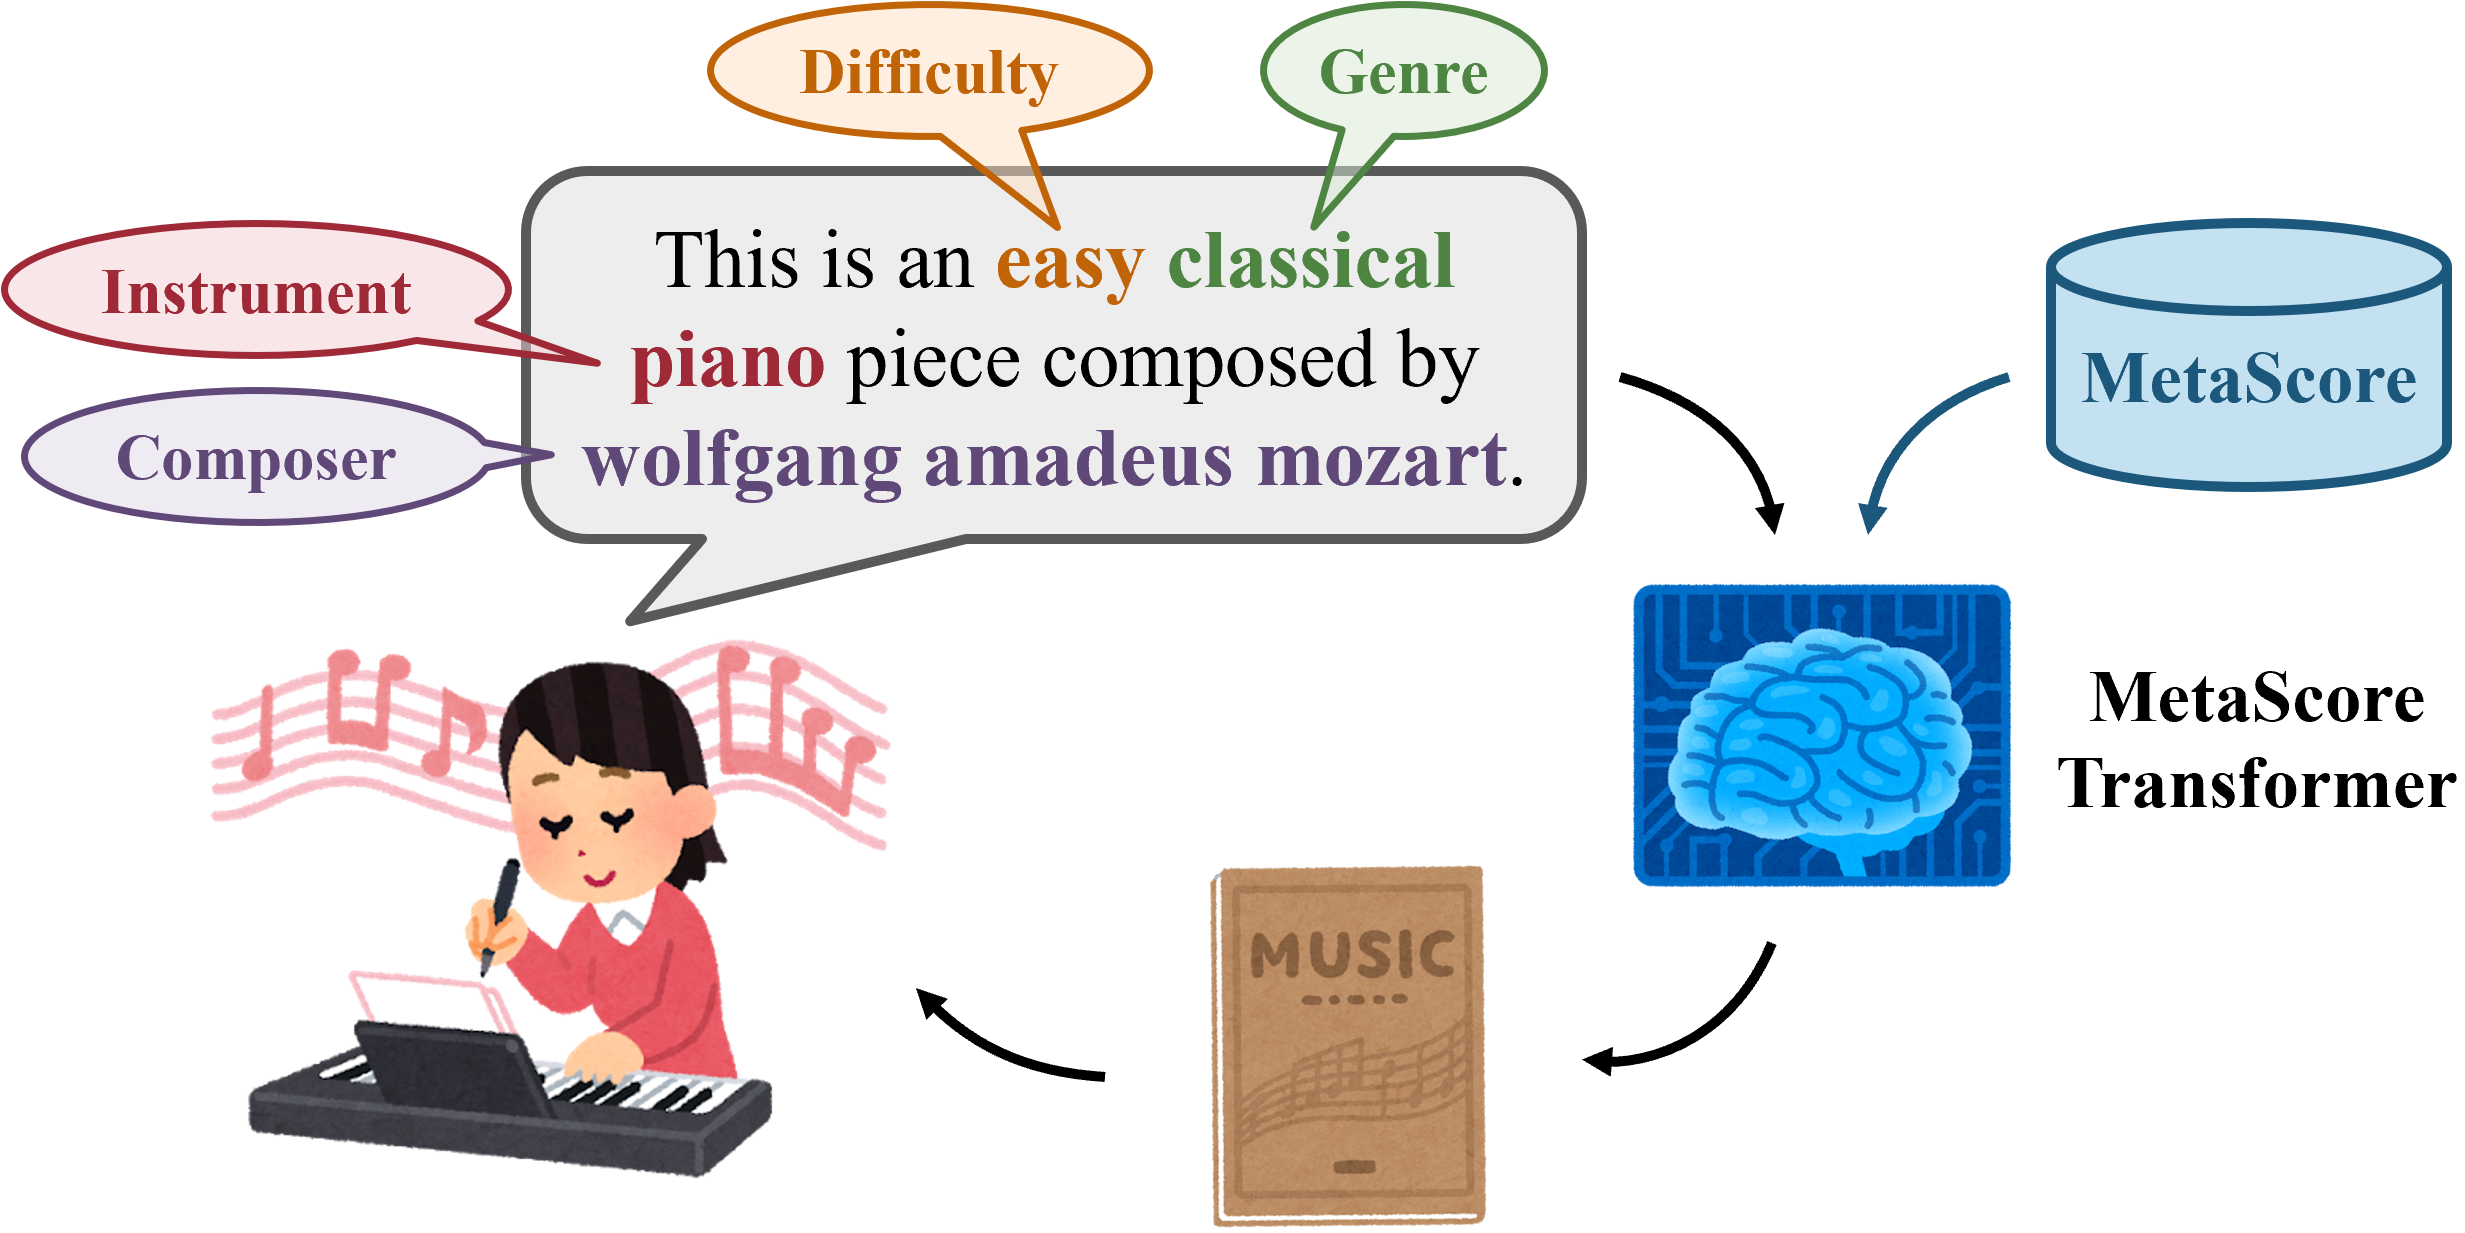
Generating Symbolic Music from Natural Language Prompts using an LLM-Enhanced Dataset
Weihan Xu, Julian McAuley, Taylor Berg-Kirkpatrick, Shlomo Dubnov, Hao-Wen Dong The 26th International Society for Music Information Retrieval(ISMIR), 2025 arXiv / demo / code We introduce MetaScore and propose a tag conditioned music generation model MST-Tag and a free-form text to symbolic music model MST-Text. |
|
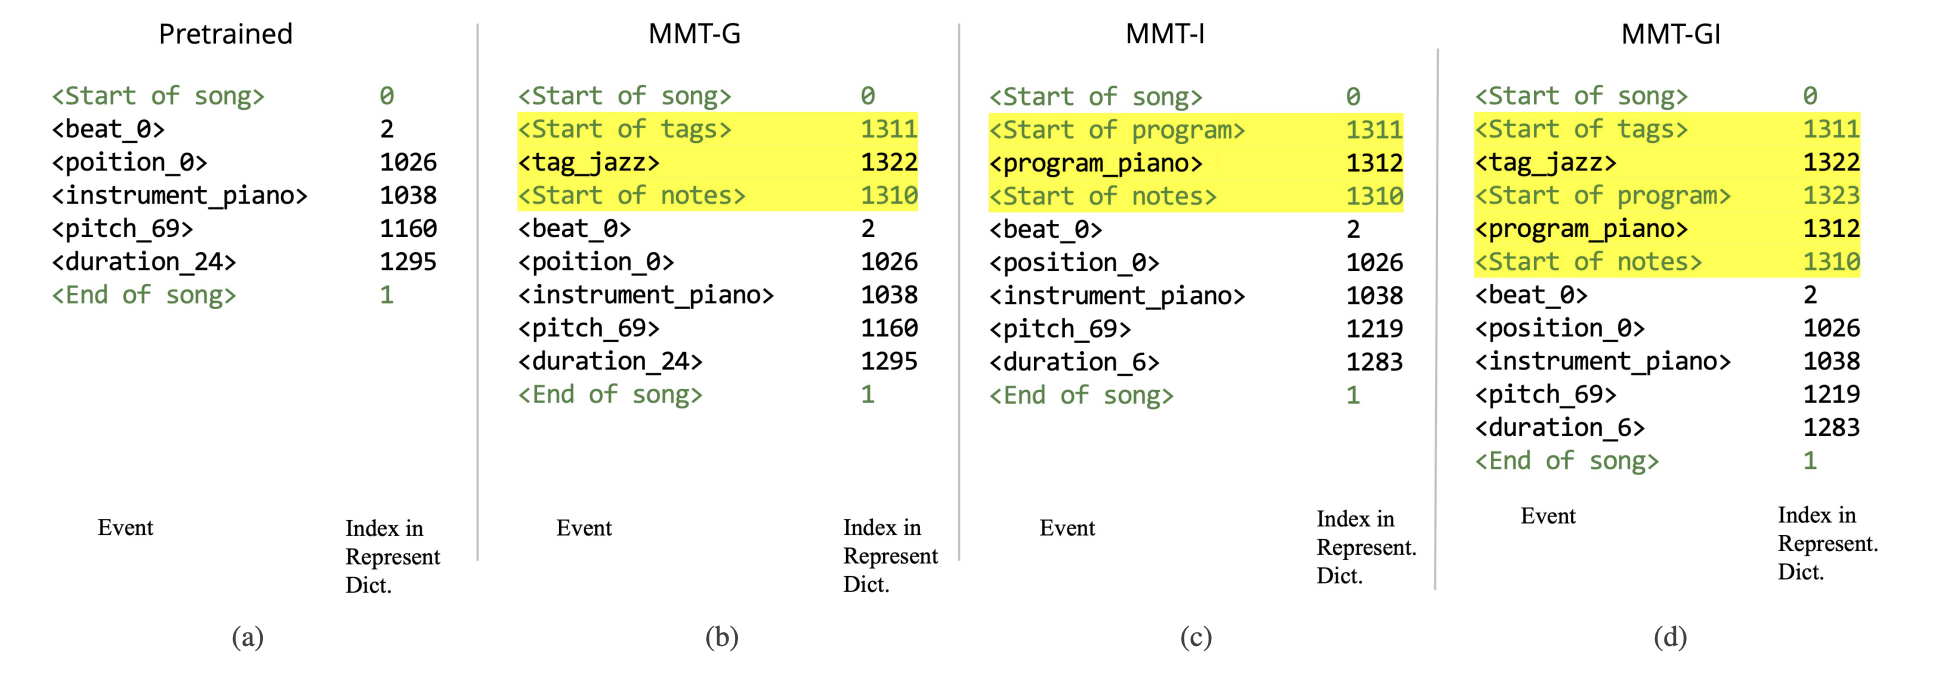
Equipping Pretrained Unconditional Music Transformers with Instrument and Genre Controls
Weihan Xu, Julian McAuley, Shlomo Dubnov, Hao-Wen Dong Big Data, 2023 arXiv We first pretrain a large unconditional transformer model using 1.5 million songs. We then propose a simple technique to equip this pretrained unconditional music transformer model with instrument and genre controls by finetuning the model with additional control tokens. |
Show all publications
-
ACTS: Learning Visuo-Tactile World Models from Human Physical Interaction
Yuxiang Ma*, Weihan Xu*, Pengfei Ye, Anna Mei, Ray Yuxin Song, Tingle Li, Haonan Chen, Yilun Du, Edward H. Adelson
CoRL 2026 Workshops: Do Robots Need World Models? & PhysWM -
AVIO: Learning to Add and Remove Sounding Objects in Audiovisual Scenes
Weihan Xu, Kan Jen Cheng, Koichi Saito, Jingyu Shi, Tingle Li, Yisi Liu, Liming Wang, Masato Ishii, Takashi Shibuya, Gopala Anumanchipalli, Paul Pu Liang
Preprint, 2026 -
Tac-Bench: Benchmarking Diverse Tactile Manipulation and Multimodal World Models
Peilin Wu, Zhiyi Li, Weihan Xu, Sam Gallaudet, Haonan Chen, Yilun Du
RSS Workshop on Tactile Sensing for Robotic Foundation Models, 2026 project page -
Clips2Story: Training-Free Video Storyboarding and Editing Using Multimodal Retrieval-Embedded Generation
Junnuo Wang, Weihan Xu, Hao-Wen Dong
Preprint, 2026 -
Schrödinger Audio-Visual Editor: Object-Level Audiovisual Removal
Weihan Xu*, Kan Jen Cheng*, Koichi Saito, Jehanzeb Mirza, Tingle Li, Yisi Liu, Alexander Liu, Liming Wang, Masato Ishii, Takashi Shibuya, Yuki Mitsufuji, Gopala Anumanchipalli, Paul Pu Liang
Preprint, 2026 arXiv / demo -
CAVE: Coherent Audio-Visual Emphasis via Schrödinger Bridge
Kan Jen Cheng*, Weihan Xu*, Koichi Saito, Nicholas Lee, Yisi Liu, Jiachen Lian, Tingle Li, Alexander Liu, Fangneng Zhan, Masato Ishii, Takashi Shibuya, Paul Pu Liang, Gopala Anumanchipalli
Preprint, 2026 -
REGen: Multimodal Retrieval-Embedded Generation for Long-to-Short Video Editing
Weihan Xu, Yimeng Ma, Jingyue Huang, Yang Li, Wenye Ma, Taylor Berg-Kirkpatrick, Julian McAuley, Paul Pu Liang, Hao-Wen Dong
NeurIPS, 2025 arXiv / demo / code -
TeaserGen: Generating Teasers for Long Documentaries
Weihan Xu, Paul Pu Liang, Haven Kim, Julian McAuley, Taylor Berg-Kirkpatrick, Hao-Wen Dong
ICLR, 2025 arXiv / demo / code -
Generating Symbolic Music from Natural Language Prompts using an LLM-Enhanced Dataset
Weihan Xu, Julian McAuley, Taylor Berg-Kirkpatrick, Shlomo Dubnov, Hao-Wen Dong
ISMIR, 2025 arXiv / demo / code -
Video-Guided Text-to-Music Generation Using Public Domain Movie Collections
Haven Kim, Zachary Novack, Weihan Xu, Julian McAuley, Hao-Wen Dong
ISMIR, 2025 -
A New Dataset for Tag- and Text-Based Conditioned Symbolic Music Generation
Weihan Xu, Julian McAuley, Taylor Berg-Kirkpatrick, Shlomo Dubnov, Hao-Wen Dong
ISMIR Late-Breaking Demo, 2024 paper -
A New Dataset, Notation Software, and Representation for Computational Schenkerian Analysis
Stephen Hahn, Weihan Xu, Jerry Yin, Rico Zhu, Simon Mak, Yue Jiang, Cynthia Rudin
ISMIR, 2024 arXiv -
Smart Tools, Smarter Concerns: Navigating Privacy Perceptions in Academic Settings
Yimeng Ma, Weihan Xu, Hongyi Yin, Yuxuan Zhang, Pardis Emami-Naeini
SOUPS Poster, 2024 abstract -
SentHYMNent: An Interpretable and Sentiment-Driven Model for Algorithmic Melody Harmonization
Stephen Hahn, Jerry Yin, Rico Zhu, Weihan Xu, Yue Jiang, Simon Mak, Cynthia Rudin
KDD Applied Data Science Track, 2024 paper -
Equipping Pretrained Unconditional Music Transformers with Instrument and Genre Controls
Weihan Xu, Julian McAuley, Shlomo Dubnov, Hao-Wen Dong
IEEE Big Data Workshop on AI Music Generation, 2023 paper
Datasets |
|
DocumentaryNet: Github
MetaScore: Github |
Projects |
|
Project: Accessibility Tools for the Visually Impaired
Collectively (in a group of four) built a website that allows visually impaired people to upload photos of surroundings and describes the photos for them; Designed various features into the website, such as giving warnings if photo includes roadblocks or other obstacles; Constructed the code and user interface for the website with one other team member |
Teaching Experience |
|
Course: Introduction to Deep Learning
Department: Electrical and Computer Engineering, Duke University Instructor: Prof. Vahid Tarokh |
Professional Service |
|
Reviewer: International Journal of Computer Vision (IJCV); NeurIPS; ISMIR; ICLR
Program Committee: NeurIPS 2025 AI for Music Workshop |
Volunteer Experience |
|
Organization: Shanghai Adream Charitable Foundation
Year: 2020 |
Miscellaneous |
|
Language: English, Chinese Interests: Music, Travel, Roller Coasters, Karting Music Instruments: Piano, French Horn, Violin. Adventures: Bungee Jumping @ 2019, Skydiving @ 2022, Visit the Arctic Circle @ 2022 |